신경망 구조 탐색은 학습하는 방법을 학습하는 것으로, 경험적 결과에 기반한 기존의 심층학습 결과에 근접
심층학습(Deep Learning)의 장점과 단점
(장점) 심층학습은 현대 인공지능 기술의 핵심으로 대규모 데이터를 학습하여 패턴을 인식하거나 미래를 예측하는 데 활용
구글 딥마인드가 개발한 인공지능 바둑 프로그램 알파고는 13층의 합성곱 신경망*, 40층의 잔차 신경망**을 활용해 바둑 지식을 학습
* 합성곱 신경망(Convolutional Neural Network)은 이세돌 9단과 대결한 알파고 버전으로 16만 개의 바둑 기보를 학습한 인공신경망
** 잔차 신경망(Residual Neural Network)은 인간의 바둑 기보 없이 스스로 대국하여 최정상 바둑실력을 증명한 알파고제로가 활용한 인공신경망 구조
사진 분류 성능을 시험하는 CIFAR-10* 데이터셋 기준 예측 오차율은 2017년 기준 2.56%(DenseNet + CutOut)
* Canadian Institute For Advanced Research의 약어로 6만 장의 사진을 10개의 종류로 구분한 이미지 데이터로, 심층학습 분야에서 이미지 분류 성능을 측정하는 기준 데이터로 활용됨
언어 모델을 시험하는 Penn Treebank* 데이터셋 기준 혼잡도(Perplexity)는 2018년 기준 56.0을 기록(Long Short-Term Memory(LSTM) 활용)1
* Penn Treebank는 문장을 형태소 별로 구분한 말뭉치 데이터셋으로 언어 모델의 성능(주어진 문장의 다음에 올 단어 예측)을 측정하는 데 활용
(단점) 심층학습은 성공적인 학습을 위해 방대한 양의 데이터가 필요하고, 높은 예측 성능에 대한 설명이 거의 불가능하며, 이로 인해 실험을 통한 경험적 결과에 의존
심층학습에서는 데이터의 절대량이 예측 성능과 직결될 가능성이 높으며, 상대적으로 빈도가 낮은 경우*를 성공적으로 예측하기 위해서는 더욱 많은 데이터를 필요로 함
* 자연재해, 보험 사기, 비정상적인 금융 거래 등 현상 자체가 빈번하게 일어나지 않는 분야를 예측하는 경우
심층학습으로 현상을 예측하는 인공신경망 모델이 왜 예측을 잘 하는지에 대한 설명 가능성*이 낮음
* 이 부분을 극복하기 위해 현재 미국의 방위고등연구계획국(DARPA)에서는 막대한 예산을 투입하여 설명 가능한 인공지능(Explainable AI) 연구를 진행 중
심층학습의 결과물인 인공신경망 모델은 그 구조가 경험적으로 얻어진 것이 일반적으로, 보다 많은 경우의 수를 상정하여 시도한 최적의 결과
신경망 구조 탐색(Neural Architecture Search, NAS) 기술은 앞서 기술한 심층학습의 세 번째 단점인 인공신경망 구조를 찾는 과정을 다시 심층학습으로 찾아내는 과정으로, 학습하는 방법을 학습하는 방법론으로 부상
신경망 구조 탐색 기술과 그 성능
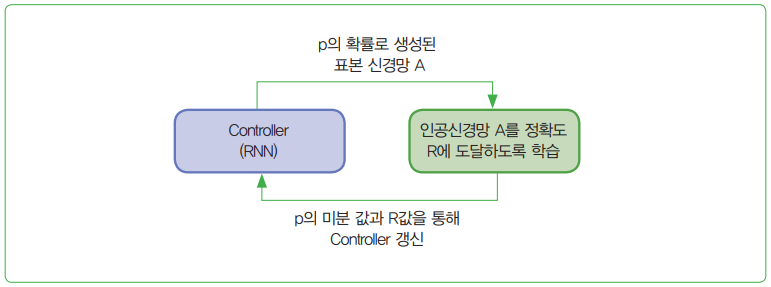
신경망 구조 탐색은 <그림 1>과 같이 순환 신경망(Recurrent Neural Network)을 통해 파생되는 신경망을 학습하여 최적의 인공신경망 구조를 탐색
인공신경망을 일종의 다변 문자열(variable-length string)으로 구체화하여 <그림 1>의 Controller는 일정 확률 p로 인공신경망 문자열(child network)을 생성
Child network는 학습 데이터로 학습되고, 검증 데이터로 정확도 R을 생성한 뒤 생성 확률인 p와 함께 Controller를 갱신
Controller는 높은 정확도를 갖는 child network에 더 높은 p 값을 부여하여 가장 예측을 잘 하는 인공신경망을 탐색
그림 1 신경망 구조 탐색의 개념
※ 출처 : Neural architecture search with reinforcement learning에서 재구성
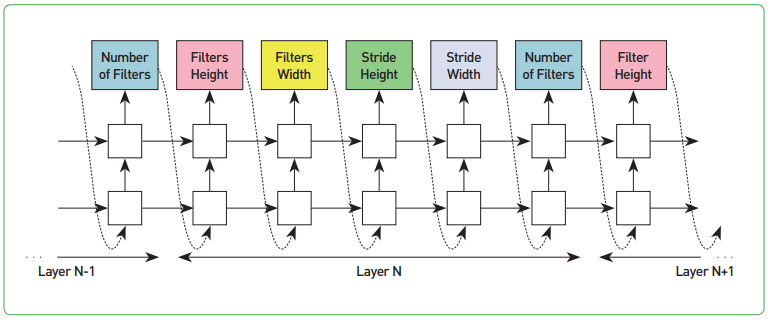
신경망 구조 탐색은 인공신경망의 구조적인 모수(architectural hyperparameter)를 탐색하는 것으로 앞먹임(feedfoward) 방식의 합성곱신경망의 모수는 <그림 2>와 같이 표현할 수 있음
그림 2 합성곱신경망의 모수를 찾기 위한 Controller의 순환신경망 구조
※ 출처 : Zoph, Barret, and Quoc V. Le. “Neural architecture search with reinforcement learning.” arXiv preprint arXiv:1611.01578(2016).
신경망 구조 탐색 역시 많은 시도로 결과를 도출하는 접근방법이기 때문에 계산의 효율을 높이기 위해서 다수의 child network를 동시에 생성하고 비동기식 병렬처리를 통해 Controller를 갱신
신경망 구조 탐색의 성능
신경망 구조 탐색의 성능은 수백 장의 고성능 GPU를 활용해 도출한 결과이나, 최근 한 장의 GPU를 활용해 효율을 극대화한 연구(Efficient Neural Architecture Search, ENAS)가 진행2
앞서 소개한 데이터셋 CIFAR-10과 Penn Treebank에 대한 성능은 다음 [표 1]과 같음
표 1 신경망 구조 탐색의 성능
<표 1> 신경망 구조 탐색의 성능
CIFAR-10
Penn Treebank
방법론
파라메터 수(백 만)
오차율(%)
방법론
파라메터 수(백 만)
혼잡도
경험적인 방법(DenseNet)
26.2
2.56
경험적인 방법(LSTM)
22
56.0
NAS
3.3
2.65
NAS
54
62.4
ENAS
4.6
2.89
ENAS
24
55.8
※ 출처 : Pham, Hieu, et al. “Efficient Neural Architecture Search via Parameter Sharing.” arXiv preprint arXiv:1802.03268(2018).
결론
신경망 구조 탐색은 경험적인 지식에 의존하는 심층학습 구조를 인공지능을 통해 학습하여 도출한다는 개념으로, 그 성능은 전통적인 방법론에 육박할 정도로 높음
그간의 연구결과는 수백 대의 고성능 컴퓨팅 자원이 필요로 한 반면, 최근 컴퓨터 한 대 수준에서의 신경망 구조 탐색 기법을 구현하여 성능을 증명함으로써, 앞으로의 심층학습 분야의 발전 가능성을 시사
1 Pham, Hieu, et al. “Efficient Neural Architecture Search via Parameter Sharing.” arXiv preprint arXiv:1802.03268(2018).
2 Pham, Hieu, et al. “Efficient Neural Architecture Search via Parameter Sharing.” arXiv preprint arXiv:1802.03268(2018).